Que valent vraiment les outils détecteurs de contenu IA ?

Image générée par IA

Je me souviens quand j’étais à la fac qu’on nous faisait chier avec des outils anti-plagiat, censés être à la pointe de la technologie, qui donnaient un pourcentage de ressemblance entre le texte écrit par l’universitaire et les sources sur lesquelles l’outil se basait.

Maintenant, j’imagine que ces outils existent encore mais qu’avec les IA génératives ils ne servent plus autant.
Aujourd’hui, on cherche plutôt à savoir si une IA a écrit un texte à la place de son auteur.
Dans tous les cas, le but est de vérifier qu’un travail est bien celui de la personne.

Note : reprendre le texte ou les images d’autres sources n’est pas interdit en soi. La recherche s’appuie justement sur ce que publient les autres chercheurs et sur les connaissances déjà acquises. Il suffit de bien distinguer ce qui est cité, en le mettant entre guillemets, et d’indiquer d’où vient l’information.

Même si ça peut paraître anodin, ces détecteurs peuvent avoir de lourdes conséquences dans certains domaines, surtout à l’université, où on peut vous exclure définitivement de tout établissement public d’enseignement supérieur avec pour conséquence une interdiction de passer des diplômes (en France en tous cas).
S’appuyer seulement sur des détecteurs faillibles peut donc tout faire basculer.

Pourquoi l’anti-plagiat ne suffit plus

Un anti-plagiat compare le texte écrit à une immense base de documents (pages web, articles, anciens documents rendus par les élèves) et mesure les ressemblances. Il faut donc qu’il y ait un original quelque part pour comparer.

Une IA générative ne copie pas, elle produit un texte nouveau, mot après mot. Il n’y a rien à retrouver, et l’outil peut afficher 0 % de ressemblance sur un texte qu’on n’a pas écrit soi-même.

S’appuyer sur Internet comme référence a aussi des limites de départ :

  • Il est incomplet : contenus payants, privés ou récents n’y figurent pas toujours.
  • Il n’est plus une référence « humaine » : les textes générés y sont de plus en plus publiés tels quels, par copier-coller. Ce qu’on cherche à détecter finit donc par contaminer la base de comparaison.
  • Les sources sont limitées, et elles n’étaient déjà pas toutes originales : bien avant les IA, beaucoup de sites se contentaient de recopier d’autres sites, tout simplement parce que le texte de départ était suffisant. L’idée même d’un « original » à retrouver était donc déjà compliqué.
  • Il y a aussi une limite plus profonde : on ne peut pas tout reformuler. Une définition, une règle de grammaire, une formule, un fait historique, un texte de loi ou une recette s’expriment souvent mieux d’une seule façon, et réécrire pour réécrire n’améliore rien, au contraire même parfois. Même un étudiant honnête qui fait l’effort de réécrire aura forcément un texte qui ressemble à d’autres sources sur ces passages. Dès qu’un texte est clair et bien écrit, la ressemblance ne prouve pas la copie : elle prouve parfois seulement qu’il n’y avait pas beaucoup d’autres façons de le dire.

Les détecteurs de style : deviner n’est pas prouver

Les détecteurs actuels (GPTZero et autres) analysent le style. Ils mesurent ce qu’on appelle la perplexité (le texte est-il très prévisible pour un modèle ?) et la burstiness (les phrases varient-elles en longueur et en structure comme le ferait un humain ?).

Ça reste des paramètres fragiles sur lesquels s’appuyer :

  • Un humain qui écrit de façon claire et régulière (texte administratif, technique, scolaire, blogueur ou journaliste) produit aussi un texte très prévisible.
  • Une IA peut être invitée à écrire familièrement, avec des fautes ou des phrases courtes.
  • Les faux positifs sont inégalement répartis. Dans une étude de Stanford publiée en 2023, 7 détecteurs ont classé à tort plus de la moitié des essais écrits par des non-anglophones comme « générés par IA ». Les mêmes outils étaient presque parfaits sur des textes d’élèves américains. Les auteurs expliquent que ces personnes utilisent un vocabulaire plus restreint, donc plus prévisible.
  • Les outils peuvent échouer même quand on les conçoit soi-même : en juillet 2023, OpenAI a retiré son propre détecteur « en raison de son faible taux de précision ». Il identifiait correctement 26 % des textes d’IA, et classait à tort 9 % des textes humains comme générés.
  • Beaucoup de textes sont mixtes : écrits par un humain, corrigés par une IA, retraduits. « Humain ou IA ? » n’a plus de réponse en oui/non.

« L’écriture humaine » n’est pas une référence stable

Un détecteur de style suppose qu’il existe une façon d’écrire typiquement humaine. Or, ce n’est absolument pas le cas ! J’ai mon style d’écriture, tout comme vous, amis blogueurs qui lisez, avez le vôtre.

On peut se demander si le temps passé sur des formats courts, qui laissent peu de place à la nuance (comme les réseaux sociaux), ne réduit pas l’entraînement à lire et à écrire des phrases longues et complexes (en gros, moins on passe de temps à lire et écrire des textes longs et moins on y arrive). Je n’ai pas trouvé de données pour lever le doute…

En orthographe, la DEPP a fait refaire la même dictée à des élèves de CM2 en 1987, 2007, 2015 et 2021 : le nombre moyen d’erreurs est passé de 10,7 à 14,7, puis 18, puis 19,4. La baisse se poursuit en 2021, mais de façon moins marquée.

Les évaluations internationales comme PISA, indiquent que le niveau en lecture baisse. Mais presque aucun test ne suit la qualité d’écriture de façon comparable dans le temps.

Attention, PISA mesure la compréhension de texte et non l’écriture, et la dictée concerne des enfants de CM2 plutôt que la population adulte. Il ne faut pas non plus conclure grand-chose des fautes qu’on voit sur les réseaux sociaux : on y écrit vite, sur téléphone, sans relecture, et ceux qui écrivent le plus ne forment pas un échantillon représentatif. Le niveau moyen est donc difficile à mesurer, ce qui rend la détection par le style encore plus fragile.

Une autre approche : marquer le texte dès sa création

Plutôt que de deviner après coup, on peut laisser une trace au moment où le texte est produit. Depuis le 2 août 2026, le code européen de transparence sur les contenus générés par IA impose aux fournisseurs de les « marquer », notamment avec une technique dite du « Watermark ».

Le principe : Quand un modèle écrit, il choisit chaque mot parmi une liste probable de mots (comme lorsqu’on essaie de deviner le mot après une phrase).
Souvent, c’est pour apporter de la nuance et ça change pas grand chose. Par exemple, après « Le temps était froid et… », on peut écrire « gris » ou « couvert », ça ne va pas changer globalement le sens du paragraphe. Ces choix se font normalement au hasard.
Avec le watermark, la source du hasard change : elle dépend d’une clé secrète et des quelques mots précédents. Le texte reste naturel et le modèle ne choisit jamais un mot aberrant. Mais quelqu’un qui possède la clé peut vérifier si la suite de mots est compatible avec ce tirage et en déduire une probabilité que l’IA ait participé.

Les limites du watermark

  • Il ne couvre pas tous les textes. Seuls les modèles lancés à partir du 2 août sont concernés. Les anciens modèles devraient être modifiés dans ce sens également.
  • Il faut assez de texte. Sur un passage court, on ne peut pas calculer le watermark de façon fiable.
  • Certains textes s’y prêtent mal. Là où il n’y a qu’une bonne réponse (un fait, une date, du code qui doit fonctionner), il n’y a pas de choix à marquer. Un texte simplement relu ou corrigé par Claude a peu de chances de porter une marque détectable.
  • Il ne prouve pas que Claude a écrit le texte. Il montre qu’il a probablement participé, pas qu’il a tout écrit : Claude a pu corriger, résumer ou traduire un texte humain (une traduction par Claude, elle, est marquée vu qu’il s’agit de texte généré).
  • L’absence de marque ne prouve rien. Un texte non marqué peut venir d’un autre modèle, qui a sa propre clé ou aucune (pas besoin d’une IA dernière génération grand public pour écrire du texte).
  • Une réécriture complète l’efface. Une retouche légère ne suffit probablement pas, mais remplacer tous les mots oui.
  • La détection est pour l’instant réservée. Un outil existe en privée, destiné aux organisations éligibles (régulateurs, médias, chercheurs, organisations éducatives, entreprises soumises à des obligations de vérification). L’accès sera élargi progressivement avec, j’imagine, les retours de faux-positifs.
  • Il n’indique pas que l’information est vraie ou faux. le watermark indique simplement qu’une IA dont on connaît la marque a probablement participé au texte, celui-ci reste sous la responsabilité de la personne qui l’utilise.

Les enjeux : pour et contre de ces détections

Les « Pour » :

  • Transparence : savoir qu’un contenu a été généré est utile pour l’information et la confiance, même si un texte généré n’est pas forcément plus faux que quelqu’un qui donne son avis ou écrit quelque chose de faux sans vérifier.
  • Un meilleur indice qu’un score de style : il repose sur une probabilité et non sur une impression.
  • Cadre légal : le marquage devient une obligation en Europe, autant qu’il soit fait sérieusement.

Les « Contre » :

  • Fausse impression de certitude : un texte marqué n’est pas forcément écrit par l’IA, un texte non marqué n’est pas forcément humain.
  • Contournement possible : réécrire en profondeur suffit.
  • Accusations injustes : mal compris, un « texte marqué » peut devenir une preuve de triche alors qu’il peut s’agir d’une simple relecture.
  • Dépendance aux fournisseurs : seuls les concepteurs détiennent les clés, et l’accès aux outils de détection reste restreint.
  • Désinformation : repérer plus facilement des contenus produits en masse et lutter contre les fausses informations.
  • Couverture partielle : chaque fournisseur a son propre système, et rien ne garantit que tous les modèles, notamment open source, jouent le jeu.
  • Pas de taux d’erreur publié : l’article d’Anthropic décrit des limites mais ne chiffre pas les faux positifs.
  • Un usage légitime risque d’être mal jugé : reformuler ou synthétiser un texte difficile avec une IA est une aide réelle. Une marque ou un détecteur ne distinguent pas cet usage d’une tricherie, alors que les idées restent celles de la personne.

Alors, que faire ?

L’Anti-plagiat comparait les textes, les détecteurs de style « devinent », le watermark donne des mesures mais incomplètes : aucun ne donne une certitude. Comprendre comment fonctionnent ces détecteurs aide également à les contourner.

Pour l’école comme pour le travail, la piste la plus solide reste d’évaluer le processus plutôt que le seul résultat : brouillons, historique de rédaction, échange à l’oral pour vérifier que la personne maîtrise ce qu’elle rend. C’est moins automatisable, mais c’est le meilleur moyen de vérifier ce qui compte vraiment : la compréhension de celui ou celle qui rend le texte.

Tous ces détecteurs anti-plagiat ou de reconnaissance de texte IA sont mis en place dans le but de s’assurer que le travail est bien celui de la personne et permettent, indirectement, de s’assurer que les connaissances sont acquises, ce que beaucoup d’élèves ne comprennent pas.

Mais ces outils le font mal.

Une note à un examen ne sert à rien, ce qui compte c’est la compréhension et avoir les connaissances indispensables pour la suite. Je pense que beaucoup d’enseignants ne montrent pas assez ce point.
Ne pas réussir un devoir ce n’est pas un échec en soi mais ne pas faire l’effort d’essayer de le faire soi-même simplement parce que des outils peuvent le faire à notre place n’aide pas du tout les élèves pour la suite.

Chercher l’information de base utile pour un exposé ne peut pas s’inventer, mais comprendre un problème ça s’apprend par l’effort.

Écrire avec une IA n’est pas un mal non plus, et assumer que le texte ait été généré par IA sera de toute façon lu de la même manière par les gens qui veulent le lire. Ce qui est important c’est d’être critique sur ce qu’on lit, c’est-à-dire d’être d’accord ou non (donc comprendre), et avoir des arguments (donc des connaissances).


En quoi l’IA sert à la désinformation ?

L’IA LLM est un outil qui permet d’écrire du texte en masse rapidement.
Les textes écrits par l’IA sont fluides, bien écrits et très plausibles.

Souvent les personnes derrière utilisent de fausses informations dans le but de manipuler des foules dans des cadres essentiellement géopolitiques mais aussi dans un but d’influencer les gens par la fabrication de faux médias, de faux comptes et de fausses personnes d’influences, des faux commentaires (grosse influence sur les réseaux sociaux) ou gagner de l’argent en vendant de faux produits.
Sans parler des fausses images générées pour influencer davantage.

Sans vouloir forcément être de mauvaise volonté, une IA hallucine et peut produire des informations fausses, surtout à grand volume et peut avoir une grande portée si la coquille passe au travers le regard humain sur un site de média par exemple. C’est aussi pour ça qu’il est important de vérifier ce qui est généré.
Mondes ouverts : suivez le geek ! – France Culture

https://www.radiofrance.fr/franceculture/podcasts/la-science-cqfd/mondes-ouverts-suivez-le-geek-6351995


Petite série de Podcast sur les jeux vidéo Jeux vidéo : des sciences qui consolent (d’autres séries sont disponibles sur leur site comme Les jeux vidéo c’est la vie ou La musique des jeux vidéo).

Pour ma part, c’est vrai que « monde ouvert » rime plutôt avec « jeu vide » et « perte de temps à ne rien faire ».

Il y a eu un boom du monde ouvert parce que nos machines sont capables de les faire tourner et que des astuces techniques permettent de ne pas avoir trop de chargement comme dans nos anciens jeux, mais clairement je préfère de bons vieux jeux avec une bonne scénarisation et un bon gameplay plutôt qu’un bac à sable pas très utile.

Par exemple, j’ai trouvé le dernier Tears of the Kingdom particulièrement chiant, rien de bien nouveau par rapport à Breath of the Wild, une carte énorme vide avec des mécaniques qui se voulaient révolutionnaires mais qui ne servent à rien dans le jeu pour avancer.
Un bac à sable, mais rien de fou, alors qu’on n’était pas foutu de chopper correctement un item par terre sans l’envoyer valser à des centaines de mètres à cause d’un coup de vent.

Une bonne petite série de podcast à écouter qui est assez intéressante.

Est-ce que nous sommes tous responsables de l’esprit critique commun ?

Image générée par IA.

Je suis sur certains réseaux sociaux pour suivre certains groupes qui me passionnent, où des gens partagent des choses qu’ils expérimentent et qui sont parfois intéressantes, ça ressemble dans le fond un peu aux forums qu’on avait il y a quelques années.

Sauf que les gens sont maintenant d’une profonde bêtise. Et tout le monde sait que discuter sur internet ça a toujours été très compliqué. Argumenter et répondre aux erreurs des gens, sans paraître pédant ni condescendant, sans rabaisser l’autre et essayer de ne pas faire partir la discussion en cacahuète demande beaucoup trop d’énergie et de temps.

Alors on se tait.

On scrolle, on souffle, et on referme l’appli sans rien dire. Corriger quelqu’un sur un groupe Facebook, c’est un peu comme vider l’océan à la petite cuillère : ça ne change jamais rien à l’échelle, et en prime on se fait traiter de donneur de leçons.

Sauf que se taire, ce n’est pas neutre.

Ne rien dire par peur de froisser des gens ou une communauté, c’est un peu comme ne pas reprendre un enfant par peur qu’il se mette à pleurer.

Ça a un nom : l’effet de vérité illusoire. Plus on est exposé à une affirmation, plus elle nous parait vraie, même quand on sait, au départ, qu’elle est fausse. Le cerveau confond familiarité et vérité. Alors chaque bêtise qu’on laisse passer sans un mot devient, un peu plus, une évidence pour tout le monde qui la croise. Moi y compris.

Bon. Donc il faudrait répondre à tout, tout le temps ?

Non plus. Et c’est là que ça devient intéressant.

Un article que j’ai lu récemment retourne le problème. Des chercheurs en sciences cognitives avancent que le raisonnement humain n’a pas vraiment évolué pour trouver la vérité tout seul, mais pour argumenter et gagner.
En fait ça serait même pire que ça : plus on affiche sa rationalité comme une vertu morale (« moi j’ai les bases, pas vous »), plus on pousse les gens à partager encore plus de conneries hostiles, juste pour ne pas perdre la face. Ce qui protège vraiment quelqu’un de tomber dans le panneau, ce n’est donc pas d’être plus intelligent. C’est l’humilité. Accepter qu’on peut se tromper, avant de sortir l’artillerie. Personne n’a la science infuse, puis quand bien même, la science change en fonction des découvertes. Vos certitudes et vos croyances ne sont pas gravées dans le marbre non plus.

Facile à dire me direz-vous. Et en vrai ? On est plutôt confronté à ça :

  • Des gens qui exigent des sources de votre part et ignorent royalement la question quand vous leur demandez les leurs.
  • Des gens qui insultent dès qu’ils sont mis face à leur propre ignorance, pas vraiment face à vous, plutôt face à eux-mêmes, ce qui doit être bien plus dur à avaler.
  • Des gens dont la conclusion, en dernier recours, est toujours la même : de toute façon, les médecins et les pharmaciens sont des menteurs, la médecine a ses œillères, et on aura raison dans vingt ans, une fois que les survivants seront morts et qu’il n’y aura plus personne à indemniser. Pratique, comme prédiction : impossible à vérifier aujourd’hui, impossible à contredire jamais.
  • Des gens qui se présentent comme « ouverts d’esprit » et qui ressortent d’une conversation avec exactement les mêmes certitudes qu’au début.

Être réellement ouvert d’esprit, ce n’est pas croire à tout. C’est être prêt à examiner une idée, même quand elle nous déplaît. Et surtout, c’est appliquer le même niveau d’exigence à ses propres croyances qu’à celles des autres.

Une étude mal faite mérite d’être critiquée. Une théorie fondée sur « on me l’a dit » ou « ça se sent » aussi, même quand elle confirme ce qu’on avait envie de croire.

L’ouverture d’esprit, ce n’est pas baisser ses critères. C’est accepter de les appliquer honnêtement à tout.

Le meilleur exemple reste Luc Montagnier. Prix Nobel pour la découverte du VIH, devenu au fil des années la référence de tous les antivax : COVID fabriqué en labo avec des séquences de VIH, vaccins responsables des variants. Ces thèses ont été combattues par les virologues et les épidémiologistes, ce qui a fini par discréditer un scientifique devenu un paria parmi ses pairs. Il n’a jamais eu raison. Mais ça n’empêche personne de continuer à le citer comme la preuve qu’« on nous cache tout » puisqu’on le censure (vous voyez l’idée).

Et si les gens raisonnent comme ça, ce n’est pas juste une histoire de psychologie individuelle. C’est aussi que l’endroit où on discute a été littéralement conçu pour ça. Le faux se propage plus loin, plus vite, plus profondément et plus largement que le vrai, dans toutes les catégories d’information. Une fausse info met environ dix heures à atteindre 1 500 personnes, contre soixante heures pour une vraie, et touche en moyenne 35 % de personnes en plus. Et ce ne sont pas des bots : ce sont des humains (article source : https://www.science.org/doi/10.1126/science.aap9559).

Ajoutez à ça que les manifestations de colère en ligne obtiennent plus de « j’aime » que les autres interactions, ce qui apprend aux utilisateurs à s’indigner de plus en plus pour être vus.

Pire encore : le nombre de « j’aime » donne l’illusion d’avoir raison. Sur les réseaux sociaux, on a tendance à être suivi par des gens qui pensent déjà comme nous, alors qu’un like ne valide pas un argument, il confirme juste qu’on parlait à des gens déjà convaincus. En face, la personne qui a de meilleurs arguments peut très bien n’obtenir aucun like, simplement parce qu’elle n’a pas le même public acquis d’avance. Le compteur mesure la taille de l’audience, pas la solidité du raisonnement.

Les algorithmes, conçus pour maximiser le temps passé sur l’appli, valorisent le contenu chargé émotionnellement, direct et sensationnel plutôt que celui qui nuance, enfermant les internautes dans des bulles propices au complotisme (ce qui s’est révélé particulièrement fertile pour les discours antivax pendant la pandémie du COVID).

Alors, responsables ou pas ?

Je crois que oui. Mais pas comme un devoir individuel de tout corriger, tout le temps, au prix de sa santé mentale. Plutôt comme un roulement : il suffit que suffisamment de gens, suffisamment souvent, avec de l’humilité plutôt que de la supériorité, empêchent l’espace de devenir un désert où seules les affirmations les plus répétées et les plus néfastes survivent.

Reste une remarque que je ne peux pas laisser de côté : demander à des individus déjà épuisés de compenser un système qui récompense l’outrage, c’est un peu leur demander de rester calmes dans une pièce où chaque cri rapporte des applaudissements. Tant que les plateformes ont un intérêt financier à ce qu’on ne se calme jamais, l’esprit critique restera épuisant à mettre en place.

Au-delà du simple perroquet qui complète les phrases ? Une explication de l’émergence

Malgré tous les problèmes qu’elles engendrent, les attentes démesurées et les conséquences des fake news, les intelligences artificielles restent de bons outils qui évoluent à une rapidité folle.

Il suffit de voir les premiers LLM (grands modèles de langage), qui pensaient que les vaches pondaient des œufs, et les premières vidéos générées. Aujourd’hui, il est devenu bien plus compliqué de distinguer le vrai du généré.

Vous pouvez faire le test sur sightengine.com/ia-ou-pas pour être un peu surpris. Même avec l’habitude, personne n’atteint 100 % de réussite.

Je suis en train de lire pas mal d’articles et de regarder pas mal de vidéos pour réellement comprendre comment ça marche (je construis un outil pédagogique en parallèle pour expliquer tout ça).

Et dans tout ce que je lis, il y a un phénomène qui me fascine : les aptitudes émergentes.

De quoi on parle ?

Des capacités qui apparaissent d’un coup, à partir d’une certaine taille de modèle, sans que personne les ait programmées ni même anticipées. Le modèle ne sait pas faire, puis d’un coup … il sait faire.

Ce qui m’a le plus surpris, c’est que même les équipes qui construisent ces systèmes admettent que, lors de l’entraînement d’une grande IA, on ne sait pas à l’avance la liste de ce qu’elle saura faire à la fin. On connaît le coût, la durée, le niveau de fluidité attendu. Mais la question « saura-t-elle résoudre un problème en plusieurs étapes ? » n’a pas de réponse calculable avant d’avoir essayé. On découvre après coup.

Petit rappel de ce dont une IA est faite

Un « neurone » artificiel ne fait rien d’impressionnant. Il reçoit des nombres, les multiplie par un « poids » (un chiffre dans un tableau), additionne le tout, et applique une petite transformation. C’est tout. Un neurone seul est aussi intéressant qu’une calculatrice à une opération.

Une grande IA en contient des milliards, organisés en couches successives. Et c’est là que ça devient intéressant : le comportement du tout ne ressemble à rien de ce que fait chaque partie.

Une image pour fixer les idées

L’analogie des fourmis : une fourmi seule suit trois ou quatre règles chimiques simples. Mais cent mille fourmis bâtissent une fourmilière ventilée, avec des greniers et des pouponnières. Personne n’a l’architecture en tête. Elle émerge de l’interaction.

L’analogie de l’eau : une seule molécule d’eau ne montre rien, mais avec des milliards de molécules on voit de l’eau qui coule, se transforme en glace, s’évapore.

Dans les années 1970, le physicien Philip Anderson publie More Is Different : quand un système grossit, des propriétés réellement nouvelles apparaissent, qu’on ne peut pas deviner en examinant l’échelle inférieure.

En 1982, John Hopfield applique cette idée aux réseaux de neurones : des capacités utiles peuvent surgir comme propriétés collectives d’un grand nombre d’éléments simples. L’intuition fondatrice était posée bien avant ChatGPT.

Le chiffre qui a lancé le débat

En 2022, une équipe de chercheurs teste des IA de tailles croissantes sur une tâche simple : additionner deux nombres de trois chiffres.

Une précision importante

Quand vous demandez à l’IA de faire des calculs aujourd’hui, elle utilise des calculatrices externes. Là, on parle d’autre chose : ce que le réseau de neurones sait faire tout seul, sans outil externe, rien d’autre que les poids appris en lisant des montagnes de texte.

On écrit « 347 + 128 = » et on regarde ce que le modèle complète, comme il complèterait n’importe quelle phrase avec des mots.

Les résultats

Taille du modèleRéussiteVerdict
6 milliards de paramètres1 %Échec total
13 milliards8 %Échec quasi total
175 milliards80 %Ça marche

Regardez bien ces trois lignes. Entre le deuxième et le troisième modèle, rien n’a changé dans la méthode : même type d’architecture, même genre de données, même objectif d’entraînement. Seule la taille a augmenté. Et la capacité est passée de « inexistante » à « fiable ».

En parallèle, la mesure globale de qualité du modèle (à quel point il prédit bien le mot suivant) s’améliorait de façon parfaitement régulière et prévisible. Une progression douce d’un côté, une falaise de l’autre.

L’équipe a recensé plus d’une centaine de capacités de ce type : traduction, raisonnement logique, écriture de code. À chaque fois : rien, rien, rien, puis quelque chose.

Un piège de calcul

Regardons les progressions :

  • Passage de 6 à 13 milliards de paramètres : ×2 sur la taille, mais le taux de réussite passe de 1 % à 8 %, soit ×8.
  • Passage de 13 à 175 milliards de paramètres : ×13 sur la taille, mais le taux de réussite passe de 8 % à 80 %, soit ×10 « seulement ».

Le deuxième saut semble moins rentable en ratio. Mais regardons les points gagnés :

  • 1 % → 8 % = +7 points
  • 8 % → 80 % = +72 points

Le « fois » trompe à cause du plafond de 100 %. Près de 0 %, un petit gain fait exploser le ratio. Près de 100 %, c’est l’inverse : le manque de marge écrase le ratio, même pour un gros progrès réel.

Un exemple publicitaire pour s’en convaincre : « Ventes +300 % » peut signifier passer de 10 à 40 unités (+30 unités), tandis que « Ventes +30 % » peut signifier passer de 10 000 à 13 000 (+3 000 unités). Le premier chiffre impressionne plus en pourcentage, mais le second représente un gain absolu bien supérieur.

Ce « détail » est le cœur du débat qui a suivi : la façon de calculer un « saut » change entièrement son interprétation.

« Et si on regardait mal ? »

En 2023, des chercheurs (Schaeffer, Miranda et Koyejo) ont avancé que c’était notre système de notation qui créait l’illusion.

L’analogie de l’archer

Un archer doit toucher cinq cibles d’affilée pour marquer un point.

  • Il touche une cible sur deux → 0 point
  • Il progresse à deux sur trois → 0 point
  • Puis neuf sur dix → il marque souvent

Son score passe de 0 à excellent d’un coup. En réalité, sa précision s’améliore régulièrement, mais c’est la règle « cinq d’affilée » qui transforme une progression douce en explosion apparente.

C’est exactement ainsi qu’on évalue les IA : une addition juste à 90 % vaut 0 point, pas 90 %.

En remplaçant cette notation « tout ou rien » par des points partiels, la progression devient plus linéaire. Les chercheurs sont même allés plus loin : ils ont créé artificiellement des « émergences » dans la reconnaissance d’images, en imposant une notation « tout ou rien » à des tâches qui progressaient normalement de façon régulière.

Sauf que ça n’explique pas tout

1. La notation de remplacement a ses limites

La mesure « à points partiels » compte les caractères à corriger. Pour « 4237 + 5487 = 9724 », la réponse « 2724 » ne se trompe que d’un caractère… pour une erreur de 7 000, ce qui est loin du résultat attendu dans les faits.

2. Des sauts persistent

Plusieurs tâches, comme la traduction, conservent des résultats en saut brutal même avec des notations progressives.

3. Le seuil n’est pas que dans la taille

D’autres chercheurs ont suivi des modèles tout au long de leur entraînement plutôt que de comparer seulement leur taille finale. Ils ont découvert que deux modèles de tailles très différentes, mais avec la même qualité d’apprentissage à un instant donné, ont sensiblement la même capacité.

Même avec des notations indulgentes, le saut persiste. Ça écarte l’explication « c’est juste un problème de notation ».

Le rôle du hasard

Pour deviner des tokens (des portions de mots, ou des mots entiers), l’IA fait des calculs à partir de très nombreux chiffres. Ces chiffres sont rangés dans des tables, un peu comme des tableurs, et au départ ils sont écrits au hasard. Pour remplir ces tableaux, on utilise ce qu’on appelle une « seed » (une graine) : un nombre qui permet de pré-remplir automatiquement les milliards de valeurs (les paramètres) de manière aléatoire. Puis, à travers l’entraînement et les calculs, l’IA modifie ces valeurs pour arriver à compléter les phrases. Une fois qu’on estime que l’IA a atteint sa capacité, les paramètres ne sont plus modifiables.

La particularité d’une IA, à la différence d’un programme classique, c’est qu’elle fait l’inverse : elle trouve des règles à partir d’exemples. Un programme informatique, lui, applique une règle déjà écrite pour répondre et calculer. C’est ce qui rend l’IA imprévisible, alors même qu’on connaît parfaitement les calculs effectués dans la machine et c’est aussi précisément ce qu’on recherche : qu’elle soit assez flexible pour s’adapter.

En entraînant beaucoup de modèles de même taille (même nombre de paramètres), avec des chiffres de départ aléatoires différents (la « seed »), certains réussissent et d’autres échouent, malgré des conditions presque identiques. C’est ce qu’a observé en 2026 une équipe menée par Rosie Zhao.

En regardant, taille par taille, combien de modèles réussissaient et combien échouaient à faire ces additions, les chercheurs ont constaté que pour les petites tailles, aucun modèle ne réussissait. Mais en augmentant la taille, la probabilité de voir des modèles y arriver augmente.

Et pour une taille intermédiaire, entre ceux qui échouent systématiquement et ceux qui réussissent systématiquement, on trouve des IA qui y arrivent et d’autres non, alors que leur entraînement était rigoureusement le même, à l’exception de leur valeur de départ.

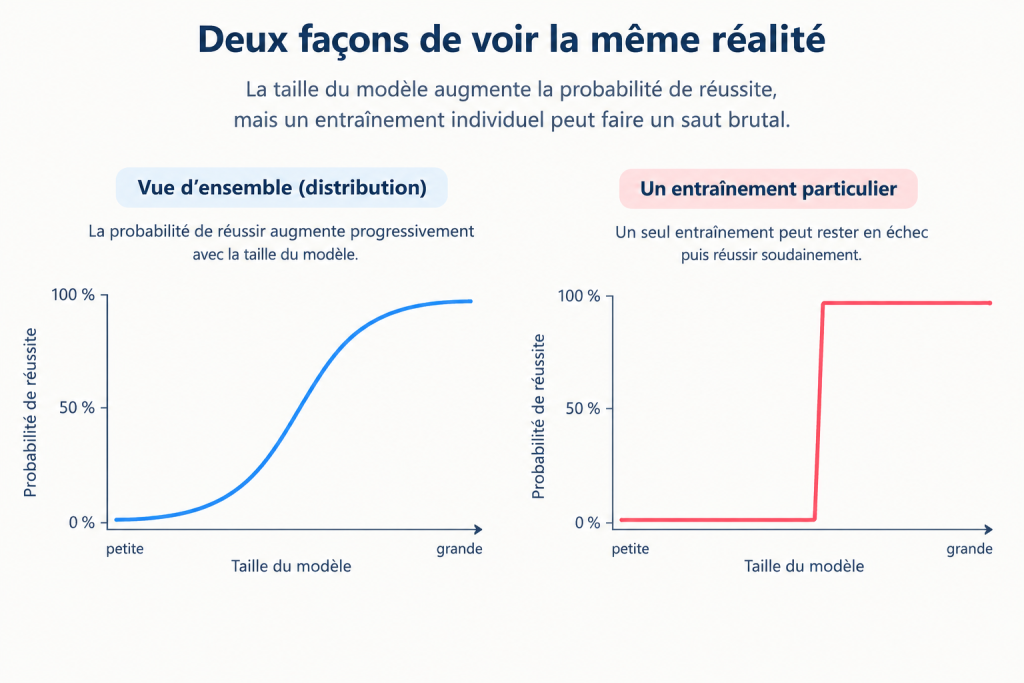
À l’échelle de nombreux entraînements, la probabilité de réussite augmente progressivement avec la taille du modèle (courbe en S, à gauche), tandis qu’un entraînement individuel peut sembler faire un saut brutal lorsqu’il découvre soudainement la bonne stratégie.

L’idée clé : un modèle plus grand a simplement plus de chances de découvrir la bonne stratégie pendant l’entraînement.

À l’échelle de nombreux entraînements, la probabilité de réussite augmente donc progressivement avec la taille du modèle (une courbe en S), tandis qu’un entraînement individuel, lui, peut sembler faire un saut brutal au moment précis où il découvre soudainement la bonne stratégie.

Ce qui se passe au moment du basculement

En 2026, une équipe de chercheurs a identifié ce qui change à l’intérieur du modèle au moment où la capacité apparaît : l’apprentissage soudain de certains motifs dans les « têtes d’attention » (le mécanisme qui permet aux éléments de texte de se relier entre eux pour former du sens).

Il semblerait que les IA apprennent par blocs : à un moment donné, un schéma mathématique particulier se met en place d’un coup, et il rend possible une nouvelle aptitude — associer des concepts plus efficacement, retrouver un mot déjà vu dans un texte, etc.

Les chercheurs montrent que forcer artificiellement ces motifs à apparaître plus tôt fait apparaître la capacité elle-même plus tôt.

Conclusion : la « seed » influence la difficulté, plus ou moins grande selon le tirage de départ, à tomber sur le bon motif d’attention. Plus un modèle est grand, plus il trouve ce motif tôt et de façon fiable, quelle que soit la seed de départ, ce qui explique enfin, mécaniquement, pourquoi la probabilité de réussite observée plus haut augmente avec la taille.

Pourquoi ça compte, concrètement

1. On ne peut pas promettre une capacité à l’avance

Quand une entreprise annonce que son prochain modèle « saura faire X », c’est un pari, pas une prédiction.

2. Compresser une IA peut tout casser

Pour faire tourner une IA sur un ordinateur ordinaire, on la « compresse ». Poussée trop loin, la compression fait s’effondrer d’un coup le raisonnement, pendant que le modèle continue à produire des phrases parfaitement normales en apparence.

3. Une nouvelle vague de sauts

Les modèles « de raisonnement » récents ont produit des bonds spectaculaires :

ÉpreuveAvantMaintenant
Olympiades de maths13 %83 %
Programmation compétitive11 %89 %
Casse-tête inédits5 %88 %

Mais ces mêmes modèles échouent parfois sur des tâches qu’un enfant réussit sans effort. Les progrès sont en dents de scie, pas uniformes ce qui confirme, une fois de plus, que les LLM apprennent par blocs plutôt que de façon régulière.

Le revers : tout ce qui émerge n’est pas souhaitable

Si des capacités utiles apparaissent sans prévenir, des capacités problématiques le peuvent aussi.

La complaisance apprise

On récompense les modèles quand les utilisateurs apprécient leurs réponses. Problème : cela récompense la satisfaction, pas la vérité. Certains modèles finissent par abonder dans le sens d’un utilisateur défendant une thèse fausse.

La contamination de comportements

Des chercheurs ont entraîné un modèle sur du code contenant des failles de sécurité.
Résultat : le modèle s’est mis à tenir des propos hostiles sur des sujets sans rapport avec la programmation alors que personne ne l’avait demandé.

L’explication avancée : « écrire du code malhonnête » et « être un assistant qui ne respecte pas les règles » partagent une région commune dans la géométrie interne du modèle. Entraîner sur l’un active l’autre.

Le « grokking » : un cas fascinant

On entraîne un modèle sur une tâche simple. Il apprend rapidement les exemples par cœur et atteint 100 % de réussite. À première vue, le modèle semble prêt. Mais si on le teste sur de nouvelles données, il échoue : il a mémorisé les réponses sans comprendre la logique sous-jacente.

Si on continue l’entraînement sur les mêmes données, des milliers d’étapes plus tard, sa capacité à généraliser explose soudainement, d’un coup.

Le modèle passe de la mémorisation à la compréhension bien après que les performances semblaient figées. Un mécanisme interne se formait en douce, invisible sur les courbes, jusqu’à prendre le dessus brutalement.

Ce qui se passe : au départ, l’IA mémorise rapidement. Puis la régularisation (une technique qui pénalise les solutions inutilement complexes) pousse progressivement le réseau à se simplifier. La mémorisation « coûte cher » en complexité de poids. À travers des milliers de petits ajustements, le réseau finit par découvrir une stratégie bien plus efficace : un algorithme général (comme la règle de la multiplication) qui fonctionne pour tous les cas, pas seulement ceux mémorisés.
Histoire de bien finir, l’IA fait le ménage dans ses paramètres pour enlever tous les schémas devenus inutiles.

Le grokking n’est pas exactement le même phénomène que l’émergence par la taille vue plus haut, l’un se joue dans le temps d’entraînement d’un modèle unique, l’autre dans la comparaison entre modèles de tailles différentes, mais les deux dessinent la même signature : une longue période où rien ne semble se passer, puis un basculement brutal.

Personne ne sait à l’avance :

  • Si le grokking va se produire
  • Quand il va se produire
  • Combien de cycles d’entraînement supplémentaires sont nécessaires, alors que rien ne semble bouger

Beaucoup d’entraînements sont probablement arrêtés juste avant qu’un grokking n’arrive, parce que les courbes semblent figées.

Pourquoi l’IA ne pense pas comme nous

Nos catégories sont vécues : on associe « chien » et « chat » parce qu’on les a touchés, vus bouger. L’IA n’a que du texte. Ses catégories sont des régularités statistiques.

Le modèle doit représenter plus de concepts qu’il n’a de neurones disponibles. Résultat : un seul neurone peut s’activer pour des séquences d’ADN, de la poésie arabe et des en-têtes HTTP, 3 choses sans lien pour nous, mais qui font « sens » pour l’IA dans ses données.

Ce n’est pas un bug, c’est une stratégie de compression que personne n’a programmée : elle émerge simplement du fait qu’il faut caser plus de concepts que de place disponible.

Concrètement, le « voisinage » entre deux idées dans la tête d’une IA ne correspond pas forcément à un voisinage de sens pour nous, mais à un voisinage statistique : deux notions qui apparaissent souvent dans des contextes similaires, même si elles n’ont, sémantiquement, aucun lien logique.

C’est pour ça que l’interprétabilité est devenue un champ de recherche crucial : personne ne peut prédire à l’avance quels concepts seront « voisins » dans un modèle donné. Il faut aller regarder après coup.

Conclusion

L’émergence n’est ni un fantasme de notation, ni un miracle. C’est une histoire de seuils cachés dans les poids d’un réseau, qu’on ne sait pas encore bien lire.

Chaque entraînement d’un grand modèle reste une expérience dont on découvre les résultats après coup. Des capacités utiles surgissent sans prévenir, mais des capacités problématiques aussi.

C’est fascinant, prometteur… et un peu inquiétant. D’où l’importance de continuer à étudier ces phénomènes pour mieux les comprendre et les anticiper.

Usurpation d’identité : les vérifications à faire après les fuites de données de l’État – ITConnect

https://www.it-connect.fr/usurpation-identite-verifications-fuites-donnees-etat

Avec toutes les fuites de données de ces derniers temps, quelques conseils/outils pour vérifier qu’on n’a pas de mauvaises surprises dans notre dos…