Non classé

L’IA a-t-elle « volé » le code libre ?

Je vois souvent des défenseurs du libre dans mes flux RSS râler allègrement sur le fait que l’IA c’est le mal absolu et que ça tue le libre.

Étant moi-même défenseur du libre et relativement investi dans cette démarche de partage, je ne partage pas cet avis très catégorique.

L’IA reste un outil assez efficace, pas pour tout c’est sûr, mais pour certains trucs oui.

Ce qui est compliqué avec les modèles IA c’est que ce ne sont pas juste de simples perroquets. Ça reste des modèles de prédictions de langage qui écrivent des choses probables, pas seulement mot après mot, mais aussi par ce qu’ils peuvent trouver comme information quand on leur donne un contexte ou qu’on leur demande de faire une recherche sur internet.

Qu’est-ce que ça implique ?

Derrière « l’IA a volé du code libre » on peut voir en réalité 3 niveaux d’approches différentes :

  • L’entraînement : le modèle a-t-il le droit de lire des millions de dépôts publics pour apprendre ?
  • La production : quand le modèle écrit du code, recopie-t-il ce qu’il a lu ou compose-t-il quelque chose de nouveau ?
  • Le droit : les licences libres (MIT, Apache, GPL…) s’appliquent-elles à ces deux étapes, et comment ?

Les confondre rend la discussion confuse, on n’est pas obligé d’être en accord ou désaccord avec tout.

Quand l’IA écrit du code, elle ne fouille pas une base de dépôts

Un modèle de langage ne contient pas une copie rangée des dépôts GitHub qu’il a vus. Il ajuste des milliards de paramètres pour prédire la suite d’un code, et il en retient des régularités : des structures de boucle, des conventions, des manières d’appeler une bibliothèque et d’écrire. C’est ce qui lui permet de produire du code pour un problème précis qu’aucun dépôt ne contient mot pour mot.

L’argument « l’IA ne fait que recopier » est donc faux dans le cas général, mais dire « elle ne recopie jamais » serait tout aussi faux.

Les points compliqués : l’entraînement et la mémorisation

Un modèle de code est entraîné sur des corpus énormes de dépôts publics, dont beaucoup sont placés sous licence avec toutes des spécificités : les licences MIT et Apache demandent de conserver une mention d’attribution, la GPL impose en plus de redistribuer les œuvres dérivées sous la même licence.

Et non, contrairement à ce que beaucoup pensent, ce n’est pas parce que c’est lisible sur internet que c’est gratuit ou libre ou qu’on peut réutiliser n’importe comment.

La mémorisation des IA a déjà été testée par des chercheurs. Une étude sur les modèles de code, qui s’est basée sur des réponses d’IA, a repéré plus de 40 000 extraits mémorisés.
Sans surprise, les modèles plus grands mémorisent davantage que les modèles plus petits et les réponses plus longues contiennent plus de code déjà appris. Un article un peu plus vieux rappelle que Copilot pouvait, selon la manière de l’interroger, produire des copies exactes de code protégé sans dire d’où ces bouts de code venaient.

Mais attention, la technologie liée aux IA évoluent vite :

  • Ces études portent sur des modèles précis, souvent plus petits et plus anciens que ceux d’aujourd’hui : elles montrent que le phénomène existe, mais ça reste des études restreintes.
  • Un extrait mémorisé n’est pas forcément un extrait protégé : une fonction basique ou une solution qui fonctionne bien et simple peut se retrouver partout sans être une création originale.

La question de fond n’est pas de savoir si l’IA « crée », mais de savoir ce qu’elle retient et ce que l’on doit faire des cas où elle restitue du travail non généré.

Ce que disent les tribunaux

Bien évidemment, comme c’est un problème il y a des cas déjà traités au niveau de la justice.
Les décisions que j’ai pu trouver sont assez mitigées et pas encore bien tranchées sur le sujet.

Ce qui est permis :

  • Apprendre, lire, s’inspirer : un humain peut lire tout le code du monde et en retenir les idées, les techniques et le style. Le droit d’auteur protège la forme exacte d’une œuvre, pas les idées ni les algorithmes.
  • Entraîner une IA sur des œuvres : aux États-Unis, deux tribunaux l’ont jugé acceptable au titre du fair use (ça permet, sous certaines conditions, d’utiliser une œuvre protégée sans autorisation, mais ses limites dépendent du contexte, de la quantité utilisée et de l’impact sur l’auteur selon les pays), à condition que les données aient été obtenues légalement et que les auteurs ne prouvent pas de préjudice de marché suffisant. En Europe, une exception de fouille de textes existe, avec un droit d’opposition.

Ce qui est interdit ou risqué :

  • Recopier un extrait protégé : c’est une contrefaçon pour un humain comme pour une IA, même sans s’en souvenir. Une ressemblance peut suffire à faire suspecter une copie quand on a vu l’œuvre.
  • Se procurer les données illégalement : constituer une bibliothèque de livres piratés n’a pas été jugé acceptable.
  • Entraîner un produit concurrent qui remplace l’œuvre d’origine.

Ce qui n’est pas tranché

  • Une licence libre (MIT, GPL…) peut-elle interdire l’entraînement d’un modèle ? Aucune décision ne l’a jugé sur le fond.

Un droit d’opposition

Le droit européen n’utilise pas le « fair use » américain. En gros, il faut vous même interdire l’accès aux IA via le fichier robots.txt de votre site par exemple ou par d’autres moyens.

Personnellement je ne suis pas contre l’utilisation de mon contenu car je n’en vis pas et que je poste pour apporter quelque chose. Mais j’ai tout de même mis mon blog sous Licence Attribution 4.0 International qui demande de citer la source de l’information (parce que sortir une information d’un chapeau ça ne vaut pas grand chose quand on ne la comprend pas).

Le règlement européen sur l’IA ne crée pas de nouveau droit d’auteur, mais il oblige les fournisseurs de modèles à usage général (ChatGPT, Gemini, Claude, etc) à adopter une politique de respect du droit d’auteur et à publier un résumé suffisamment détaillé des données d’entraînement. Le code de bonnes pratiques publié le 10 juillet 2025 détaille ces obligations.

Après, ça reste des bonnes pratiques écrites, il faut les mettre en place, les vérifier, sanctionner…

« On ne part jamais de rien »

Un développeur apprend en lisant le code des autres, en suivant des tutoriels, en adaptant une réponse trouvée en ligne, en s’appuyant sur des bibliothèques libres. Personne ne réinvente des fonctions « basiques » comme du tri. Le logiciel libre repose d’ailleurs sur cette idée : le code est publié pour être lu, réutilisé et amélioré par quiconque en aurait le temps et l’envie.

Le droit d’auteur protège l’expression d’un code, pas les idées ni les algorithmes qu’il met en œuvre. Apprendre un style, une architecture ou une technique à partir de code publié n’est donc pas, en soi, une faute.

Il y a pourtant des limites :

  • Le problème d’échelle : un codeur peut lire quelques milliers de fichiers dans sa vie, un modèle d’IA est entraîné sur une quantité astronomique (plusieurs millions, voire plus ?).
  • Un développeur qui colle du code GPL dans un produit propriétaire enfreint la licence, même s’il l’a « appris » quelque part.
    La même règle vaut pour un modèle qui recrache un extrait protégé.
  • La traçabilité : un humain peut citer la source d’un extrait, un modèle ne le peut généralement pas sauf s’il ne traite pas l’information « de mémoire » et fait une recherche sur internet (ce qu’il ne fait pas de lui-même).

Ce n’est pas la première fois

L’accusation de « vol » accompagne presque chaque technologie qui transforme la façon de copier, d’indexer ou de réutiliser des œuvres.

D’après mes recherches avec l’IA :
Au début du XXe siècle, les rouleaux perforés des pianos mécaniques ont déjà forcé le droit d’auteur à s’adapter. Plus tard, les studios de cinéma ont poursuivi Sony à cause du magnétoscope Betamax, avant que la justice américaine ne reconnaisse certains usages privés de l’enregistrement. Même histoire avec les moteurs de recherche : en 2015, Google a gagné son procès contre des auteurs pour avoir numérisé des millions de livres afin de les rendre consultables.
il y a eu aussi un cas avec les miniatures enregistrées par Google pour mieux afficher les demandes.

Et j’ajouterais : qui n’a jamais téléchargé de MP3 avant que les plateformes de streaming sous licence ne popularisent un autre modèle de rémunération ? Parce que bon, remplir un lecteur MP3 de plusieurs Gb de musique ça demandait un certain coût si tout avait été acheté.

Ça ne prouve pas que toute copie devient légitime mais ça montre que chaque rupture technologique oblige à revoir la limite entre « réutilisation – contrefaçon – rémunération des créateurs ».

Au final, ni interdiction totale ni liberté totale, mais des licences collectives, des accords et de nouvelles règles. C’est ce qui manque encore pour encadrer correctement l’IA qui est assez récente (en plus d’un modèle économique fiable).

Les autres critiques de l’IA

En plus de reprocher le vol de données, on peut également parler d’autres critiques liés :

  • Les robots d’entraînement qui utilisent des ressources : Par exemple, Wikimedia a vu sa bande passante multimédia augmenter de 50 % depuis 2024. Les éditeurs d’IA disent respecter robots.txt, mais des développeurs rapportent des contournements et les petits sites qui voient la consommation de bande passante prise d’assaut (au risque de mettre le site en surcharge et de le rendre indisponible).
    Ce qui est déjà arrivé : l’« effet Slashdot » et les robots d’indexation agressifs des années 2000 mettaient déjà à genoux des petits serveurs, et les agrégateurs d’actualités ont capté le trafic de la presse, jusqu’à la loi sur les droits voisins de 2019 en France.
  • La consommation d’énergie : l’AIE (Agence Internationale de l’Énergie) prévoit que la consommation des centres de données double d’ici 2030, ce qui pourrait correspondre à environ 3 % de l’électricité mondiale. La part reste modeste et l’efficacité progresse, mais l’impact local peut être fort.
    Ce qui est déjà arrivé : le Bitcoin, avec une consommation énergétique relativement élevée ; mais aussi Internet, dont on prédisait à la fin des années 1990 qu’il engloutirait une part énorme de l’électricité. L’efficacité des centres de données a largement démenti ces prévisions : une étude de 2020 estime que la puissance de calcul a été multipliée par environ 6 entre 2010 et 2018 pour une hausse de consommation d’environ 6 %. Rien ne garantit que l’IA suive la même courbe.
    Mais comme toute nouvelle technologie ou confort elle demande de l’énergie qui vient forcément de ressources finies (on n’a pas encore inventé l’énergie à fusion nucléaire).

J’ai essayé de trouver les chiffres de comparaison, ce n’est pas simple car l’IA et les Data Centers ne sont pas une catégorie référencée dans la consommation comme « Industrie » vu que les Data centres sont impliqués dans les catégories.
Avec les valeurs de l’AIE j’ai obtenu ce graphe :
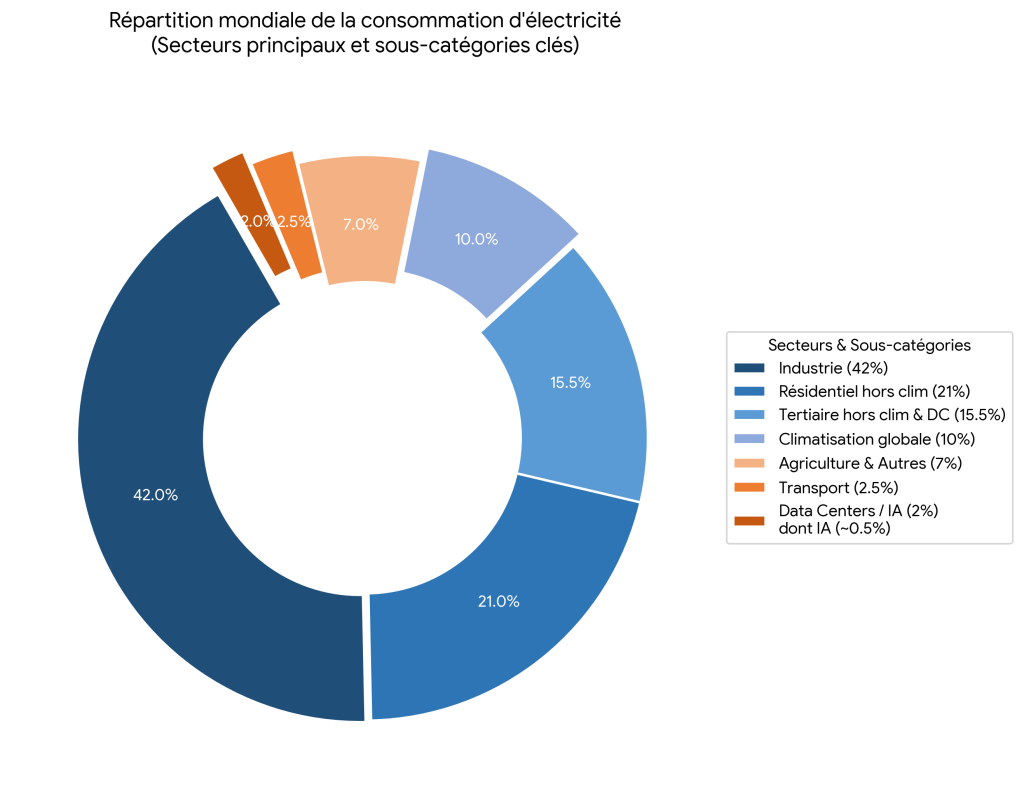
Graphique de la répartition mondiale de la consommation d'électricité par secteur : Industrie 42%, Résidentiel 21%, Tertiaire 15,5%, Data Centers / IA 2%
  • Travailleurs sous-payés : Même si l’IA est informatique, elle demande un travail humain pur améliorer et traiter les demandes dans des pays où le coût de la main d’oeuvre n’est pas élevée comme au Kénya, des travailleurs sous-payés fournissent le plus gros du travail comme dans beaucoup de domaines malheureusement.
    Ce qui est déjà arrivé : le textile, l’électronique (Foxconn), les modérateurs de contenu de Facebook sous-traités, le micro-travail d’Amazon, etc. Ce problème existe encore.
  • Développeurs submergés : Depuis que l’IA est utilisé pour traiter du code, beaucoup de rapport sont envoyés dans des projets pour indiquer des erreurs souvent faux. De très nombreux tickets à traiter par les développeurs sont générés, beaucoup plus qu’ils ne peuvent les traiter et demandent un temps de travail hors norme.
  • Contenus de mauvaise qualité : l’IA facilite la production en masse de textes et d’images médiocres.
    Ce qui est déjà arrivé : le spam des années 1990-2000, les fermes de contenu et le spam SEO. La parade a été technique (filtres antispam, mises à jour de l’algorithme de Google), mais c’est resté une course permanente.
  • Prix des appareils : L’IA demande beaucoup de calculs en parallèle qui ne peuvent se faire efficacement qu’avec des GPU (des processeurs graphiques avec beaucoup de mémoire RAM qui permettent un calcul extrêmement rapide).
    Ce qui est déjà arrivé : l’envolée du prix des cartes graphiques pendant le boom du minage (2017-2021), la pénurie de semi-conducteurs du Covid et les cycles récurrents de hausse de la mémoire DRAM. Ces hausses retombent en général quand la capacité de production augmente.
  • Risque de crise économique : Une technologie peut être prometteuse tout en provoquant une bulle financière.
    Ce qui est déjà arrivé : Internet en 2000 : les investisseurs ont massivement financé les entreprises du secteur, mais beaucoup ont ensuite fait faillite. Pourtant, Internet a continué à se développer, et une partie de la fibre optique installée en trop a finalement été utilisée quelques années plus tard.
    Le parallèle avec l’IA : même si l’IA transforme réellement notre économie, certaines entreprises peuvent être trop surcôtées en Bourse. Si la bulle financière éclate, les investisseurs pourraient perdre beaucoup d’argent, sans que l’IA perde pour autant son utilité ou son avenir.

Le schéma se répète d’une technologie à l’autre : une technique réellement utile, de la spéculation, des coûts reportés sur des tiers (créateurs, travailleurs, bénévoles, environnement), puis un rattrapage plus ou moins lent par le droit et la régulation.

L’IA deviendra-t-elle un bien commun ?

L’internet n’est pas un bien commun d’un seul bloc : ses protocoles sont ouverts, mais les câbles, les serveurs et la plupart des services appartiennent à des entreprises. Les routes suivent une logique proche, avec une infrastructure collective sur laquelle circulent des véhicules privés.

On ne sait pas encore à quoi l’IA pourrait servir dans quelques années, pour le moment on en voit que le début.

L’IA pourrait suivre trois voies :

  • Un commun ouvert, comme Linux : des modèles publiés et financés collectivement, mais limités par le coût de l’entraînement.
  • Un service régulé, comme l’électricité : des modèles privés, soumis à des règles d’accès et de transparence.
  • Du tout privé, comme actuellement, si aucune règle ne s’impose.

Un mélange de ces voies est possible, avec des standards et des modèles ouverts, et d’autres privées ou régulées. Ça dépendra des choix politiques et du coût de la technologie. Si l’IA s’entraîne sur des ressources communes, n’a-t-elle pas un devoir de « rendre » à la collectivité un service ?
Est-ce que nous sommes tous responsables de l’esprit critique commun ?

Image générée par IA.

Je suis sur certains réseaux sociaux pour suivre certains groupes qui me passionnent, où des gens partagent des choses qu’ils expérimentent et qui sont parfois intéressantes, ça ressemble dans le fond un peu aux forums qu’on avait il y a quelques années.

Sauf que les gens sont maintenant d’une profonde bêtise. Et tout le monde sait que discuter sur internet ça a toujours été très compliqué. Argumenter et répondre aux erreurs des gens, sans paraître pédant ni condescendant, sans rabaisser l’autre et essayer de ne pas faire partir la discussion en cacahuète demande beaucoup trop d’énergie et de temps.

Alors on se tait.

On scrolle, on souffle, et on referme l’appli sans rien dire. Corriger quelqu’un sur un groupe Facebook, c’est un peu comme vider l’océan à la petite cuillère : ça ne change jamais rien à l’échelle, et en prime on se fait traiter de donneur de leçons.

Sauf que se taire, ce n’est pas neutre.

Ne rien dire par peur de froisser des gens ou une communauté, c’est un peu comme ne pas reprendre un enfant par peur qu’il se mette à pleurer.

Ça a un nom : l’effet de vérité illusoire. Plus on est exposé à une affirmation, plus elle nous parait vraie, même quand on sait, au départ, qu’elle est fausse. Le cerveau confond familiarité et vérité. Alors chaque bêtise qu’on laisse passer sans un mot devient, un peu plus, une évidence pour tout le monde qui la croise. Moi y compris.

Bon. Donc il faudrait répondre à tout, tout le temps ?

Non plus. Et c’est là que ça devient intéressant.

Un article que j’ai lu récemment retourne le problème. Des chercheurs en sciences cognitives avancent que le raisonnement humain n’a pas vraiment évolué pour trouver la vérité tout seul, mais pour argumenter et gagner.
En fait ça serait même pire que ça : plus on affiche sa rationalité comme une vertu morale (« moi j’ai les bases, pas vous »), plus on pousse les gens à partager encore plus de conneries hostiles, juste pour ne pas perdre la face. Ce qui protège vraiment quelqu’un de tomber dans le panneau, ce n’est donc pas d’être plus intelligent. C’est l’humilité. Accepter qu’on peut se tromper, avant de sortir l’artillerie. Personne n’a la science infuse, puis quand bien même, la science change en fonction des découvertes. Vos certitudes et vos croyances ne sont pas gravées dans le marbre non plus.

Facile à dire me direz-vous. Et en vrai ? On est plutôt confronté à ça :

  • Des gens qui exigent des sources de votre part et ignorent royalement la question quand vous leur demandez les leurs.
  • Des gens qui insultent dès qu’ils sont mis face à leur propre ignorance, pas vraiment face à vous, plutôt face à eux-mêmes, ce qui doit être bien plus dur à avaler.
  • Des gens dont la conclusion, en dernier recours, est toujours la même : de toute façon, les médecins et les pharmaciens sont des menteurs, la médecine a ses œillères, et on aura raison dans vingt ans, une fois que les survivants seront morts et qu’il n’y aura plus personne à indemniser. Pratique, comme prédiction : impossible à vérifier aujourd’hui, impossible à contredire jamais.
  • Des gens qui se présentent comme « ouverts d’esprit » et qui ressortent d’une conversation avec exactement les mêmes certitudes qu’au début.

Être réellement ouvert d’esprit, ce n’est pas croire à tout. C’est être prêt à examiner une idée, même quand elle nous déplaît. Et surtout, c’est appliquer le même niveau d’exigence à ses propres croyances qu’à celles des autres.

Une étude mal faite mérite d’être critiquée. Une théorie fondée sur « on me l’a dit » ou « ça se sent » aussi, même quand elle confirme ce qu’on avait envie de croire.

L’ouverture d’esprit, ce n’est pas baisser ses critères. C’est accepter de les appliquer honnêtement à tout.

Le meilleur exemple reste Luc Montagnier. Prix Nobel pour la découverte du VIH, devenu au fil des années la référence de tous les antivax : COVID fabriqué en labo avec des séquences de VIH, vaccins responsables des variants. Ces thèses ont été combattues par les virologues et les épidémiologistes, ce qui a fini par discréditer un scientifique devenu un paria parmi ses pairs. Il n’a jamais eu raison. Mais ça n’empêche personne de continuer à le citer comme la preuve qu’« on nous cache tout » puisqu’on le censure (vous voyez l’idée).

Et si les gens raisonnent comme ça, ce n’est pas juste une histoire de psychologie individuelle. C’est aussi que l’endroit où on discute a été littéralement conçu pour ça. Le faux se propage plus loin, plus vite, plus profondément et plus largement que le vrai, dans toutes les catégories d’information. Une fausse info met environ dix heures à atteindre 1 500 personnes, contre soixante heures pour une vraie, et touche en moyenne 35 % de personnes en plus. Et ce ne sont pas des bots : ce sont des humains (article source : https://www.science.org/doi/10.1126/science.aap9559).

Ajoutez à ça que les manifestations de colère en ligne obtiennent plus de « j’aime » que les autres interactions, ce qui apprend aux utilisateurs à s’indigner de plus en plus pour être vus.

Pire encore : le nombre de « j’aime » donne l’illusion d’avoir raison. Sur les réseaux sociaux, on a tendance à être suivi par des gens qui pensent déjà comme nous, alors qu’un like ne valide pas un argument, il confirme juste qu’on parlait à des gens déjà convaincus. En face, la personne qui a de meilleurs arguments peut très bien n’obtenir aucun like, simplement parce qu’elle n’a pas le même public acquis d’avance. Le compteur mesure la taille de l’audience, pas la solidité du raisonnement.

Les algorithmes, conçus pour maximiser le temps passé sur l’appli, valorisent le contenu chargé émotionnellement, direct et sensationnel plutôt que celui qui nuance, enfermant les internautes dans des bulles propices au complotisme (ce qui s’est révélé particulièrement fertile pour les discours antivax pendant la pandémie du COVID).

Alors, responsables ou pas ?

Je crois que oui. Mais pas comme un devoir individuel de tout corriger, tout le temps, au prix de sa santé mentale. Plutôt comme un roulement : il suffit que suffisamment de gens, suffisamment souvent, avec de l’humilité plutôt que de la supériorité, empêchent l’espace de devenir un désert où seules les affirmations les plus répétées et les plus néfastes survivent.

Reste une remarque que je ne peux pas laisser de côté : demander à des individus déjà épuisés de compenser un système qui récompense l’outrage, c’est un peu leur demander de rester calmes dans une pièce où chaque cri rapporte des applaudissements. Tant que les plateformes ont un intérêt financier à ce qu’on ne se calme jamais, l’esprit critique restera épuisant à mettre en place.

À quoi bon blinder la porte si les murs sont en cartons ?

Je sais pas si vous lisez les mails concernant les « incidents de sécurité » que vous recevez ?

On voit la créativité pour minimiser l’impact de « l’incident » comme ils aiment appeler surtout quand les données sensibles sont conservées alors qu’il n’y a aucune raison qu’elles soient gardées et encore moins non-chiffrées.

Puis c’est pas comme s’il y avait depuis plusieurs mois des incidents à répétition et que personne ne s’est dit « Oh tiens, ça serait peut-être pas mal qu’on améliore notre sécurité interne avant que ça nous arrive dessus ».

Non ? Non.

Voir aussi : https://lokoyote.eu/piratage-administratif-vers-une-minimisation-de-la-gravite-des-donnees-volees/

Dans beaucoup de mail pour prévenir de l’incident, à la fin, on voit souvent des recommandations, parce que mea culpa oupsi maintenant que c’est fait ben c’est à vous de faire attention hein !

On retrouve souvent :

  • Vigilance face au phishing (hameçonnage)
  • Surveillance de vos comptes bancaires

Mais ma recommandation préférée reste :

  • Changer de mot de passe et activer la double-authentification !

Bah oui évidemment c’est à cause de mon mot de passe à 35 caractères que le vilain pirate est entré !
C’est sûr que changer le mot de passe maintenant que toutes mes infos sensibles sont parties va bien aider à sécuriser mon compte. Me voilà rassuré, merci de m’avoir prévenu !

Les seuls cas où ça peut être utile c’est si jamais il n’y a « pas grand chose » (même si c’est toujours trop par rapport à ce que ça devrait) qui a été volé, genre votre nom, prénom, adresse et un truc qui sert pas vraiment (à part avoir des infos qui permettent de commencer à avoir un dossier complet sur vous).

Dans cette situation, en général, le pirate n’a pas réussi à passer par la fenêtre de la maison, ni à travers les murs, et il s’est contenté de ce qu’il pouvait. La porte peut encore être forcée mais, le risque n’est présent que si vous avez mis le même mot de passe sur plusieurs autres sites qui ont déjà été pillé, du coup il suffit de tester les mots de passe qu’ils ont de vous et prendre le reste des informations.

Il y a autant de chance de trouver votre nouveau mot de passe que l’ancien s’il n’est pas un mot simple court ou qui a un rapport avec votre identité. Une bonne grosse phrase qui n’a aucun sens est mieux.

Sinon, clairement, ça sert à rien de changer son mot de passe, le pirate a déjà toutes les infos, c’est trop tard.

Chaque information volée sur vous est cumulable : sur un site on peut avoir vos coordonnées, sur un autre votre numéro de sécurité social, sur un autre votre IBAN, etc. Il suffit de garder toutes les informations et de les mettre gentiment dans un dossier en attendant d’avoir tout ce qu’il faut pour usurper l’identité de quelqu’un.

On m’a transféré un mail concernant le piratage, pardon, l’incident de sécurité de la mutuelle Solimut du mois dernier (plus d’1,2 million de données volées tout de même hein).

https://www.cyberattaque.org/solimut-mutuelle-pres-de-125-million-dassures-dans-une-fuite-massive-de-donnees

Qu’est-ce qu’il y a dans ce mail ?

Pas grand chose à part dire que ce qui a été dérobé n’est que :

  • Votre numéro d’individu (un numéro de référencement interne à notre Mutuelle) ;
  • Vos nom et prénom, ainsi que votre nom marital ;
  • Le pays, la ville et votre date de naissance ;
  • Votre adresse postale, votre adresse électronique et votre numéro de téléphone (s’ils nous avaient été communiqués) ;
  • Votre numéro de sécurité sociale (NIR) ;
  • Votre identifiant de connexion à l’extranet et votre mot de passe chiffré. S’agissant de votre mot de passe chiffré, il n’a donc pas pu être récupéré de manière lisible et exploitable en l’état. Par précaution nous vous recommandons tout de même de le changer, partout où vous l’auriez utilisé ;
  • Le numéro de votre pièce d’identité, ses dates de validité et son type (passeport, carte d’identité, titre de séjour, permis de conduire), en fonction de celui que vous nous aviez communiqué. Seuls des éléments textuels ont été dérobés, le document en lui-même ne fait pas partie de la fuite.

Rien de grave à part toutes les infos d’une vie qui ne peuvent pas être changées et qu’il n’y a plus qu’à compléter par d’autres fuites pour avoir un profil complet prêt à l’emploi pour usurper l’identité de quelqu’un.

Je comprends même pas comment des informations aussi importantes ne sont pas chiffrées.

(Si ça ce n’est pas de la négligence je me demande ce que c’est…)

En Corée du Sud, on sanctionne les entreprise qui ont manqué de sécurité par de grosses sanctions financières. En France ? On tape sur les doigts avec la CNIL et on envoie des mails, à croire que c’est vraiment pas important.

Peut-on « Vibe coder » sans savoir coder ?

Il y a quelque chose d’assez vertigineux (au départ) dans le fait de pouvoir dire à une machine « crée-moi une application » et de la voir apparaître, en quelques minutes, sous ses yeux. On a l’impression de pouvoir d’un coup tout faire et de pouvoir créer facilement tout un tas de choses !

Coder sans savoir coder ?

La réponse courte est oui. Le vibe coding permet à quelqu’un qui n’a jamais écrit une ligne de code de produire, en quelques échanges avec une IA de type LLM, une application qui fonctionne.

Le vibe coding c’est ça : décrire dans le prompt d’une IA qui génère du texte, un projet pour le transformer en code fonctionnel et potentiellement en une application visuel.

Grossière on pourrait dire que c’est simple, il suffit de :

  1. Choisir le bon modèle d’IA adapté (oui parce que tous les modèles ne se valent pas).
  2. Décrire ce que vous voulez (déjà, écrire un vrai prompt suffisamment précis et exhaustif de ce qu’on veut c’est pas si simple).
  3. L’IA génère le code.
  4. Tester (à condition de savoir quoi tester).
  5. Faire des retouts sur les erreurs à l’IA (à condition de savoir quoi lui remonter comme problème).
  6. Elle corrige.
  7. Vous recommencez (et si vous êtes curieux, vous comprenez comment votre code est fait).

Et si vous ne comprenez pas ce que l’IA a produit, il suffit de lui demander d’expliquer le fichier comme si vous n’aviez jamais programmé de votre vie.

Pour des prototypes, de petits outils, des sites vitrines ou des automatisations, cette mécanique va étonnamment loin. Le début du vibe coding est facile, presque trop facile.

Je vois souvent des influenceurs dire « Oh regardez ce que l’IA a fait ! » en montrant un vidéo d’une page HTML avec des animations, une ébauche de jeu vidéo qui pompe un style (un clone de CoD, RocketLeague et j’en passe).

Ce qu’il faut comprendre c’est que l’IA connaît le code car il existe beaucoup beauuuuucoup de projets sur internet qui ont servi à son entraînement auxquels s’ajoutent de nombreux exemples de programmation pédagogique.

Une IA générative n’invente pas le logiciel à partir de rien. Elle apprend des régularités à partir d’énormes quantités d’exemples et les recombine pour produire une solution plausible. Elle peut donc produire quelque chose de nouveau dans sa forme, mais cela ne signifie pas qu’elle comprend nécessairement le problème comme le ferait un concepteur humain.

Les projets générés par IA sont souvent assez beaux et épurés.
Clairement, 80% du boulot peut être fait en un prompt quand il est bien écrit.

Comprendre qu’un programme n’est pas seulement ce qu’on voit sur un écran est déjà pas simple pour beaucoup de gens.

L’exemple le plus parlant de mon entourage ce sont les « j’ai fait mon site internet avec ChatGPT ». Ok, tu as fait une page HTML jolie, mais où tu l’héberges ? Comment tu fais ta visibilité ? Est-ce que ça marche vraiment ? Comment tu modifies les pages ?

Donc écrire « Fais moi un jeu comme RocketLeague » c’est clairement insuffisant.

Demander à l’IA de faire un projet n’est pas la même chose que de demander à l’IA de vous aider à le faire. Dans le premier cas c’est l’IA qui fait, dans le 2e c’est vous.

Mais…

Tant que tout va bien, on avance vite. Le problème surgit lorsque quelque chose bloque, ou que le projet gagne en complexité : authentification, base de données, sécurité, déploiement, bugs subtils, performances, etc.

Pour les petits bugs, avec des IA payantes en mode « code », on peut continuellement modifier le programme (jusqu’à ce que l’IA soit surchargée de texte et se mélange les pinceaux à cause de sa fenêtre contextuelle trop petite).

Ce genre de « détails » ne se voit pas à l’œil nu, elle se voit trois semaines plus tard, quand une faille de sécurité est exploitée ou qu’une base de données mal pensée s’effondre sous la charge.

C’est à ce moment que quelques fondamentaux cessent d’être optionnels : les variables et les fonctions, les conditions et les boucles, les bases du HTML/CSS/JavaScript, la logique des API et du JSON, le fonctionnement de Git, les principes des bases de données, quelques notions de sécurité. Rien d’extraordinaire pour quelqu’un qui sait coder ou qui connaît les notions, mais assez pour comprendre ce que la machine fait, et surtout pour repérer quand elle se trompe.

Le bon modèle n’est donc probablement pas « apprendre à coder puis vibe coder », ni l’inverse absolu « vibe coder et ne jamais rien apprendre ». C’est plutôt : vibe coder d’abord, pour se lancer et garder la motivation puis apprendre juste assez pour comprendre, contrôler et corriger ce que l’IA produit.

Beaucoup de codeurs utilisent maintenant l’IA comme assistant plutôt que de pratiquer le vibe coding au sens strict (une confiance aveugle au code de l’IA). Cela leur fait gagner énormément de temps, mais la relecture reste indispensable car une IA n’est qu’un générateur de texte à la base qui est capable de produire une réponse convaincante tout en se trompant.

Un projet « fini » n’est pas un projet abouti

Un projet généré par IA donne très vite l’impression d’être terminé. Une belle page d’accueil, des cartes bien alignées, une navigation plausible, quelques animations, une typographie soignée : à première vue, on jurerait un produit fini.

Même les ébauches de « jeux vidéo » semblent prometteurs avec quelques interactions.

C’est ce qu’on pourrait appeler le phénomène du « 80/20 visuel ».

Un LLM atteint une grande partie de la finition apparente en un temps record, mais ces derniers 10 à 20 % peuvent concentrer une part disproportionnée du travail réel.

La fameuse « loi de Pareto ».

Ces petits 20% manquants sont souvent ce qui fait la différence :

  • les micro-ajustements de mise en page.
  • la cohérence entre toutes les pages et tous les états de l’interface.
  • les cas limites et les comportements inhabituels.
  • les sécurités.
  • les transitions, espacements, alignements et hiérarchies visuelles.
  • la gestion de données réelles, imprévisibles.
  • l’accessibilité, la gestion des erreurs, le responsive, les performances.
  • la cohérence du système visuel sur la durée.
  • etc

Il suffit de poser quelques questions simples pour se rendre compte que le fond n’est pas encore fini : que se passe-t-il si la donnée est vide ? Si le titre fait trois lignes au lieu d’une ? Sur mobile ? Avec deux cents éléments dans la liste ? En cas d’erreur réseau ? Après le cinquième clic sur le même bouton ? Quand deux composants qui se ressemblent doivent évoluer différemment ?
C’est là qu’on découvre que les fameux « 20 % restants » ne sont pas des détails cosmétiques mais l’architecture réelle du produit.

Tous ces trucs pénibles à corriger mais essentiels.

Du coup, on peut se demander si plus un LLM devient bon en génération visuelle, plus il risque de créer l’illusion d’un projet terminé.

Une interface magnifique donne envie de penser qu’un projet est fini puisqu’on nous a toujours appris à faire la mise en forme à la fin.

Cela ne veut pas dire que les projets générés par IA sont systématiquement bâclés ! Certains, notamment des interfaces assez standards, peuvent effectivement être quasi finalisables directement.

Ce qu’un LLM fait très bien :

  • explorer rapidement plusieurs directions différentes.
  • produire la structure globale.
  • traduire une intention floue en interface concrète.
  • générer les composants répétitifs.
  • rendre le projet utilisable dans la grande majorité des cas simples.
  • accélérer considérablement les premiers 70 à 90 % du travail.

Ce qu’un LLM fait beaucoup moins bien :

  • sentir qu’un alignement est « légèrement faux ».
  • garder une cohérence parfaite sur trente écrans différents.
  • anticiper tous les cas d’usage réels.
  • choisir les compromis.
  • juger qu’un détail visuellement insignifiant est en réalité important pour un utilisateur.

Ce dernier segment peut représenter une part disproportionné du temps total du projet, parce qu’il ne s’agit plus d’ajouter des éléments mais de traquer des incohérences, souvent invisibles tant qu’on n’a pas cherché à les voir. De modifier des choses initialement cohérentes pour les ajuster.

Le LLM n’est pas un concepteur qui remplace le travail humain. C’est une machine extrêmement rapide pour produire une première solution plausible.

On peut demander à des agents IA de se surveiller entre eux en jouant des rôles, ça permet de gagner encore plus de temps mais il faut tout de même une surveillance.
On n’aura certainement pas une IA qui écrit du code toute seule pour des grands projets, mais une chaîne de contrôles entre plusieurs IA qui rend possible des projets presque automatisés.

L’IA peut inspecter, exécuter et même tester visuellement une partie de ce qu’elle produit, mais cela ne garantit pas qu’elle juge correctement le résultat du point de vue d’un utilisateur réel.

Si on reprend l’exemple de RocketLeague : il faut comprendre le ressenti du véhicule, la maniabilité, l’effet de caméra, la gestion réelle de la latence avec d’autres joueurs en situation réelle (et pas seulement sur un ordinateur en local), l’équilibrage de la difficulté, etc.

Le codeur reste encore celui qui décide, quels détails comptent vraiment, et reste celui qui vérifie que l’ensemble tient réellement debout.

Le vibe coding ne supprime pas la programmation. Il déplace la difficulté et laisse plus de temps pour gérer des problèmes de fond importants (c’est pas comme si on avait des fuites de données à gogo en ce moment par exemple).

Je pense qu’on peut réellement faire de beaux projets avec des bonnes idées même en « vibe codant » sans être codeur. De même qu’on peut avoir un bon sens artistique et des idées mais ne pas savoir retranscrire son imagination (par le dessin, la musique ou la vidéo). Ou simplement, ne pas avoir le temps de coder de A à Z quand ce n’est pas notre métier.

À ce moment, le Vibe coding est une solution facile pour retranscrire ses idées en quelque chose de concret.

Peut-être que ça déplace l’humain vers les tâches ingrates du codes qu’on voulait justement laisser aux robots ?
Peut-être que l’IA ne supprime finalement pas le travail difficile du code : elle supprime surtout une partie du travail facile à automatiser et laisse à l’humain les décisions, les arbitrages et les problèmes que l’on ne peut pas simplement résoudre en générant davantage de code.
On peut commencer à sen rendre compte en vibe codant justement.

L’étiquetage des contenus IA devient obligatoire dans l’UE – blogdumoderateur.com

https://www.blogdumoderateur.com/etiquetage-contenus-ia-obligatoire-ue

En gros, une étiquette va devenir obligatoire dès le mois d’août pour certains contenus générés par IA.

Sont ciblés notamment les vidéos et photos générées (notamment deepfakes ou faux contenus) par IA.

Quant aux textes créés ou modifiés par IA devront être signalés lorsqu’ils :

  • concernent des sujets d’intérêt public
  • sont destinés à informer le public
  • n’ont pas fait l’objet d’un contrôle éditorial ou d’une responsabilité humaine clairement assumée (coucou les sites de « journalisme » résumé en IA).

On compte bien évidemment sur la bonne foi des gens qui en font leur business pour montrer à tout le monde qu’il n’y a aucun job derrière tout ça (n’est-ce pas les milliers de comptes Youtube avec des vidéos IA ? Ou encore les influenceurs qui ont pas envie de vraiment bosser et qui diffusent n’importe quoi ?)

Mais !

« L’obligation d’étiquetage ne s’applique pas lorsque le texte généré par IA a fait l’objet d’un processus de révision humaine ou de contrôle éditorial et qu’une personne physique ou morale assume la responsabilité éditoriale de la publication ».

Ça ressemblerait presque à une porte de sortie dites-donc !

Du coup, qu’est-ce qu’un véritable contrôle humain ?

Dans un exemple : Une IA qui écrit 90 % du texte. Le rédacteur vérifie quelques éléments, améliore le style et publie.

Est-ce que c’est du contrôle humain ? Est-ce qu’il faut une approbation humaine pour valider l’article en cliquant sur un bouton pour dire qu’il y a un contrôle ?

Comment le vérifier ? Quelle sanction y a-t-il si ce n’est pas fait ?


En contrepartie il est demandé aux fournisseurs de systèmes d’IA générative de faire en sorte que les sorties générées (audio, image, vidéo, texte synthétique) soient « marquées dans un format lisible par machine et identifiables comme ayant été générées ou manipulées par une IA », c’est-à-dire, des watermarks (filigranes) ou des données dans les métadonnées (les trucs qui sont effacés quand on met des photos sur les réseaux sociaux).

(https://ai-act-service-desk.ec.europa.eu/fr/ai-act/article-50)

On est sauvé, c’est pas comme si il existait énormément de modèles IA qu’on peut héberger soi-même et qui passent à côté des radars.

Heureusement que les grosses plateformes ont aussi des IA pour détecter les contenus générés, alors qu’elles sont pas capables de vérifier des publications signalées correctement…