Je vois souvent des défenseurs du libre dans mes flux RSS râler allègrement sur le fait que l’IA c’est le mal absolu et que ça tue le libre.
Étant moi-même défenseur du libre et relativement investi dans cette démarche de partage, je ne partage pas cet avis très catégorique.
L’IA reste un outil assez efficace, pas pour tout c’est sûr, mais pour certains trucs oui.
Ce qui est compliqué avec les modèles IA c’est que ce ne sont pas juste de simples perroquets. Ça reste des modèles de prédictions de langage qui écrivent des choses probables, pas seulement mot après mot, mais aussi par ce qu’ils peuvent trouver comme information quand on leur donne un contexte ou qu’on leur demande de faire une recherche sur internet.
Qu’est-ce que ça implique ?
Derrière « l’IA a volé du code libre » on peut voir en réalité 3 niveaux d’approches différentes :
- L’entraînement : le modèle a-t-il le droit de lire des millions de dépôts publics pour apprendre ?
- La production : quand le modèle écrit du code, recopie-t-il ce qu’il a lu ou compose-t-il quelque chose de nouveau ?
- Le droit : les licences libres (MIT, Apache, GPL…) s’appliquent-elles à ces deux étapes, et comment ?
Les confondre rend la discussion confuse, on n’est pas obligé d’être en accord ou désaccord avec tout.
Quand l’IA écrit du code, elle ne fouille pas une base de dépôts
Un modèle de langage ne contient pas une copie rangée des dépôts GitHub qu’il a vus. Il ajuste des milliards de paramètres pour prédire la suite d’un code, et il en retient des régularités : des structures de boucle, des conventions, des manières d’appeler une bibliothèque et d’écrire. C’est ce qui lui permet de produire du code pour un problème précis qu’aucun dépôt ne contient mot pour mot.
L’argument « l’IA ne fait que recopier » est donc faux dans le cas général, mais dire « elle ne recopie jamais » serait tout aussi faux.
Les points compliqués : l’entraînement et la mémorisation
Un modèle de code est entraîné sur des corpus énormes de dépôts publics, dont beaucoup sont placés sous licence avec toutes des spécificités : les licences MIT et Apache demandent de conserver une mention d’attribution, la GPL impose en plus de redistribuer les œuvres dérivées sous la même licence.
Et non, contrairement à ce que beaucoup pensent, ce n’est pas parce que c’est lisible sur internet que c’est gratuit ou libre ou qu’on peut réutiliser n’importe comment.
La mémorisation des IA a déjà été testée par des chercheurs. Une étude sur les modèles de code, qui s’est basée sur des réponses d’IA, a repéré plus de 40 000 extraits mémorisés.
Sans surprise, les modèles plus grands mémorisent davantage que les modèles plus petits et les réponses plus longues contiennent plus de code déjà appris. Un article un peu plus vieux rappelle que Copilot pouvait, selon la manière de l’interroger, produire des copies exactes de code protégé sans dire d’où ces bouts de code venaient.
Mais attention, la technologie liée aux IA évoluent vite :
- Ces études portent sur des modèles précis, souvent plus petits et plus anciens que ceux d’aujourd’hui : elles montrent que le phénomène existe, mais ça reste des études restreintes.
- Un extrait mémorisé n’est pas forcément un extrait protégé : une fonction basique ou une solution qui fonctionne bien et simple peut se retrouver partout sans être une création originale.
La question de fond n’est pas de savoir si l’IA « crée », mais de savoir ce qu’elle retient et ce que l’on doit faire des cas où elle restitue du travail non généré.
Ce que disent les tribunaux
Bien évidemment, comme c’est un problème il y a des cas déjà traités au niveau de la justice.
Les décisions que j’ai pu trouver sont assez mitigées et pas encore bien tranchées sur le sujet.
Ce qui est permis :
- Apprendre, lire, s’inspirer : un humain peut lire tout le code du monde et en retenir les idées, les techniques et le style. Le droit d’auteur protège la forme exacte d’une œuvre, pas les idées ni les algorithmes.
- Entraîner une IA sur des œuvres : aux États-Unis, deux tribunaux l’ont jugé acceptable au titre du fair use (ça permet, sous certaines conditions, d’utiliser une œuvre protégée sans autorisation, mais ses limites dépendent du contexte, de la quantité utilisée et de l’impact sur l’auteur selon les pays), à condition que les données aient été obtenues légalement et que les auteurs ne prouvent pas de préjudice de marché suffisant. En Europe, une exception de fouille de textes existe, avec un droit d’opposition.
Ce qui est interdit ou risqué :
- Recopier un extrait protégé : c’est une contrefaçon pour un humain comme pour une IA, même sans s’en souvenir. Une ressemblance peut suffire à faire suspecter une copie quand on a vu l’œuvre.
- Se procurer les données illégalement : constituer une bibliothèque de livres piratés n’a pas été jugé acceptable.
- Entraîner un produit concurrent qui remplace l’œuvre d’origine.
Ce qui n’est pas tranché
- Une licence libre (MIT, GPL…) peut-elle interdire l’entraînement d’un modèle ? Aucune décision ne l’a jugé sur le fond.
Un droit d’opposition
Le droit européen n’utilise pas le « fair use » américain. En gros, il faut vous même interdire l’accès aux IA via le fichier robots.txt de votre site par exemple ou par d’autres moyens.
Personnellement je ne suis pas contre l’utilisation de mon contenu car je n’en vis pas et que je poste pour apporter quelque chose. Mais j’ai tout de même mis mon blog sous Licence Attribution 4.0 International qui demande de citer la source de l’information (parce que sortir une information d’un chapeau ça ne vaut pas grand chose quand on ne la comprend pas).
Le règlement européen sur l’IA ne crée pas de nouveau droit d’auteur, mais il oblige les fournisseurs de modèles à usage général (ChatGPT, Gemini, Claude, etc) à adopter une politique de respect du droit d’auteur et à publier un résumé suffisamment détaillé des données d’entraînement. Le code de bonnes pratiques publié le 10 juillet 2025 détaille ces obligations.
Après, ça reste des bonnes pratiques écrites, il faut les mettre en place, les vérifier, sanctionner…
« On ne part jamais de rien »
Un développeur apprend en lisant le code des autres, en suivant des tutoriels, en adaptant une réponse trouvée en ligne, en s’appuyant sur des bibliothèques libres. Personne ne réinvente des fonctions « basiques » comme du tri. Le logiciel libre repose d’ailleurs sur cette idée : le code est publié pour être lu, réutilisé et amélioré par quiconque en aurait le temps et l’envie.
Le droit d’auteur protège l’expression d’un code, pas les idées ni les algorithmes qu’il met en œuvre. Apprendre un style, une architecture ou une technique à partir de code publié n’est donc pas, en soi, une faute.
Il y a pourtant des limites :
- Le problème d’échelle : un codeur peut lire quelques milliers de fichiers dans sa vie, un modèle d’IA est entraîné sur une quantité astronomique (plusieurs millions, voire plus ?).
- Un développeur qui colle du code GPL dans un produit propriétaire enfreint la licence, même s’il l’a « appris » quelque part.
La même règle vaut pour un modèle qui recrache un extrait protégé. - La traçabilité : un humain peut citer la source d’un extrait, un modèle ne le peut généralement pas sauf s’il ne traite pas l’information « de mémoire » et fait une recherche sur internet (ce qu’il ne fait pas de lui-même).
Ce n’est pas la première fois
L’accusation de « vol » accompagne presque chaque technologie qui transforme la façon de copier, d’indexer ou de réutiliser des œuvres.
D’après mes recherches avec l’IA :
Au début du XXe siècle, les rouleaux perforés des pianos mécaniques ont déjà forcé le droit d’auteur à s’adapter. Plus tard, les studios de cinéma ont poursuivi Sony à cause du magnétoscope Betamax, avant que la justice américaine ne reconnaisse certains usages privés de l’enregistrement. Même histoire avec les moteurs de recherche : en 2015, Google a gagné son procès contre des auteurs pour avoir numérisé des millions de livres afin de les rendre consultables.
il y a eu aussi un cas avec les miniatures enregistrées par Google pour mieux afficher les demandes.
Et j’ajouterais : qui n’a jamais téléchargé de MP3 avant que les plateformes de streaming sous licence ne popularisent un autre modèle de rémunération ? Parce que bon, remplir un lecteur MP3 de plusieurs Gb de musique ça demandait un certain coût si tout avait été acheté.
Ça ne prouve pas que toute copie devient légitime mais ça montre que chaque rupture technologique oblige à revoir la limite entre « réutilisation – contrefaçon – rémunération des créateurs ».
Au final, ni interdiction totale ni liberté totale, mais des licences collectives, des accords et de nouvelles règles. C’est ce qui manque encore pour encadrer correctement l’IA qui est assez récente (en plus d’un modèle économique fiable).
Les autres critiques de l’IA
En plus de reprocher le vol de données, on peut également parler d’autres critiques liés :
- Les robots d’entraînement qui utilisent des ressources : Par exemple, Wikimedia a vu sa bande passante multimédia augmenter de 50 % depuis 2024. Les éditeurs d’IA disent respecter robots.txt, mais des développeurs rapportent des contournements et les petits sites qui voient la consommation de bande passante prise d’assaut (au risque de mettre le site en surcharge et de le rendre indisponible).
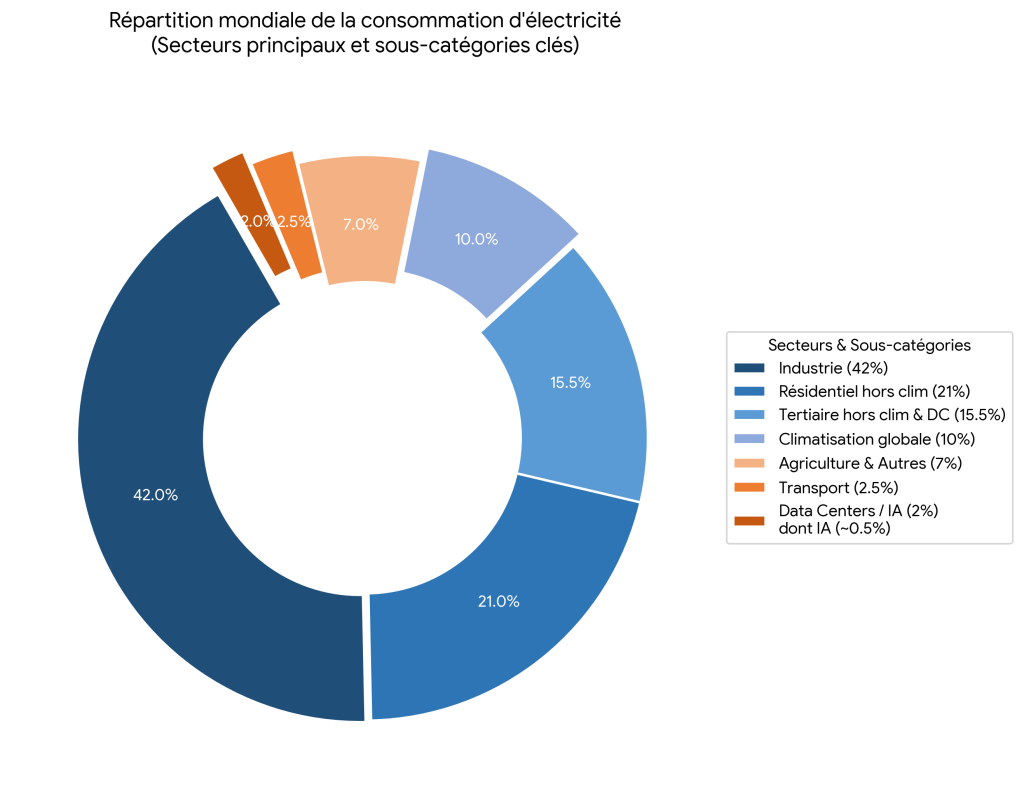
Ce qui est déjà arrivé : l’« effet Slashdot » et les robots d’indexation agressifs des années 2000 mettaient déjà à genoux des petits serveurs, et les agrégateurs d’actualités ont capté le trafic de la presse, jusqu’à la loi sur les droits voisins de 2019 en France. - La consommation d’énergie : l’AIE (Agence Internationale de l’Énergie) prévoit que la consommation des centres de données double d’ici 2030, ce qui pourrait correspondre à environ 3 % de l’électricité mondiale. La part reste modeste et l’efficacité progresse, mais l’impact local peut être fort.
Ce qui est déjà arrivé : le Bitcoin, avec une consommation énergétique relativement élevée ; mais aussi Internet, dont on prédisait à la fin des années 1990 qu’il engloutirait une part énorme de l’électricité. L’efficacité des centres de données a largement démenti ces prévisions : une étude de 2020 estime que la puissance de calcul a été multipliée par environ 6 entre 2010 et 2018 pour une hausse de consommation d’environ 6 %. Rien ne garantit que l’IA suive la même courbe.
Mais comme toute nouvelle technologie ou confort elle demande de l’énergie qui vient forcément de ressources finies (on n’a pas encore inventé l’énergie à fusion nucléaire).
J’ai essayé de trouver les chiffres de comparaison, ce n’est pas simple car l’IA et les Data Centers ne sont pas une catégorie référencée dans la consommation comme « Industrie » vu que les Data centres sont impliqués dans les catégories.
Avec les valeurs de l’AIE j’ai obtenu ce graphe :
- Travailleurs sous-payés : Même si l’IA est informatique, elle demande un travail humain pur améliorer et traiter les demandes dans des pays où le coût de la main d’oeuvre n’est pas élevée comme au Kénya, des travailleurs sous-payés fournissent le plus gros du travail comme dans beaucoup de domaines malheureusement.
Ce qui est déjà arrivé : le textile, l’électronique (Foxconn), les modérateurs de contenu de Facebook sous-traités, le micro-travail d’Amazon, etc. Ce problème existe encore. - Développeurs submergés : Depuis que l’IA est utilisé pour traiter du code, beaucoup de rapport sont envoyés dans des projets pour indiquer des erreurs souvent faux. De très nombreux tickets à traiter par les développeurs sont générés, beaucoup plus qu’ils ne peuvent les traiter et demandent un temps de travail hors norme.
- Contenus de mauvaise qualité : l’IA facilite la production en masse de textes et d’images médiocres.
Ce qui est déjà arrivé : le spam des années 1990-2000, les fermes de contenu et le spam SEO. La parade a été technique (filtres antispam, mises à jour de l’algorithme de Google), mais c’est resté une course permanente. - Prix des appareils : L’IA demande beaucoup de calculs en parallèle qui ne peuvent se faire efficacement qu’avec des GPU (des processeurs graphiques avec beaucoup de mémoire RAM qui permettent un calcul extrêmement rapide).
Ce qui est déjà arrivé : l’envolée du prix des cartes graphiques pendant le boom du minage (2017-2021), la pénurie de semi-conducteurs du Covid et les cycles récurrents de hausse de la mémoire DRAM. Ces hausses retombent en général quand la capacité de production augmente. - Risque de crise économique : Une technologie peut être prometteuse tout en provoquant une bulle financière.
Ce qui est déjà arrivé : Internet en 2000 : les investisseurs ont massivement financé les entreprises du secteur, mais beaucoup ont ensuite fait faillite. Pourtant, Internet a continué à se développer, et une partie de la fibre optique installée en trop a finalement été utilisée quelques années plus tard.
Le parallèle avec l’IA : même si l’IA transforme réellement notre économie, certaines entreprises peuvent être trop surcôtées en Bourse. Si la bulle financière éclate, les investisseurs pourraient perdre beaucoup d’argent, sans que l’IA perde pour autant son utilité ou son avenir.
Le schéma se répète d’une technologie à l’autre : une technique réellement utile, de la spéculation, des coûts reportés sur des tiers (créateurs, travailleurs, bénévoles, environnement), puis un rattrapage plus ou moins lent par le droit et la régulation.
L’IA deviendra-t-elle un bien commun ?
L’internet n’est pas un bien commun d’un seul bloc : ses protocoles sont ouverts, mais les câbles, les serveurs et la plupart des services appartiennent à des entreprises. Les routes suivent une logique proche, avec une infrastructure collective sur laquelle circulent des véhicules privés.
On ne sait pas encore à quoi l’IA pourrait servir dans quelques années, pour le moment on en voit que le début.
L’IA pourrait suivre trois voies :
- Un commun ouvert, comme Linux : des modèles publiés et financés collectivement, mais limités par le coût de l’entraînement.
- Un service régulé, comme l’électricité : des modèles privés, soumis à des règles d’accès et de transparence.
- Du tout privé, comme actuellement, si aucune règle ne s’impose.
Un mélange de ces voies est possible, avec des standards et des modèles ouverts, et d’autres privées ou régulées. Ça dépendra des choix politiques et du coût de la technologie. Si l’IA s’entraîne sur des ressources communes, n’a-t-elle pas un devoir de « rendre » à la collectivité un service ?